# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) — это модель компьютерного зрения, обучаемая в режиме самообучения, которая предварительно обучается путём маскирования значительной части изображения (~75%). Кодер обрабатывает видимые фрагменты изображения, а декодер восстанавливает отсутствующие пиксели на основе закодированных фрагментов и токенов маски. После предварительного обучения кодер можно повторно использовать для задач, следующих за ним, таких как классификация изображений или обнаружение объектов, — часто он превосходит по качеству модели, обученные с учителем.
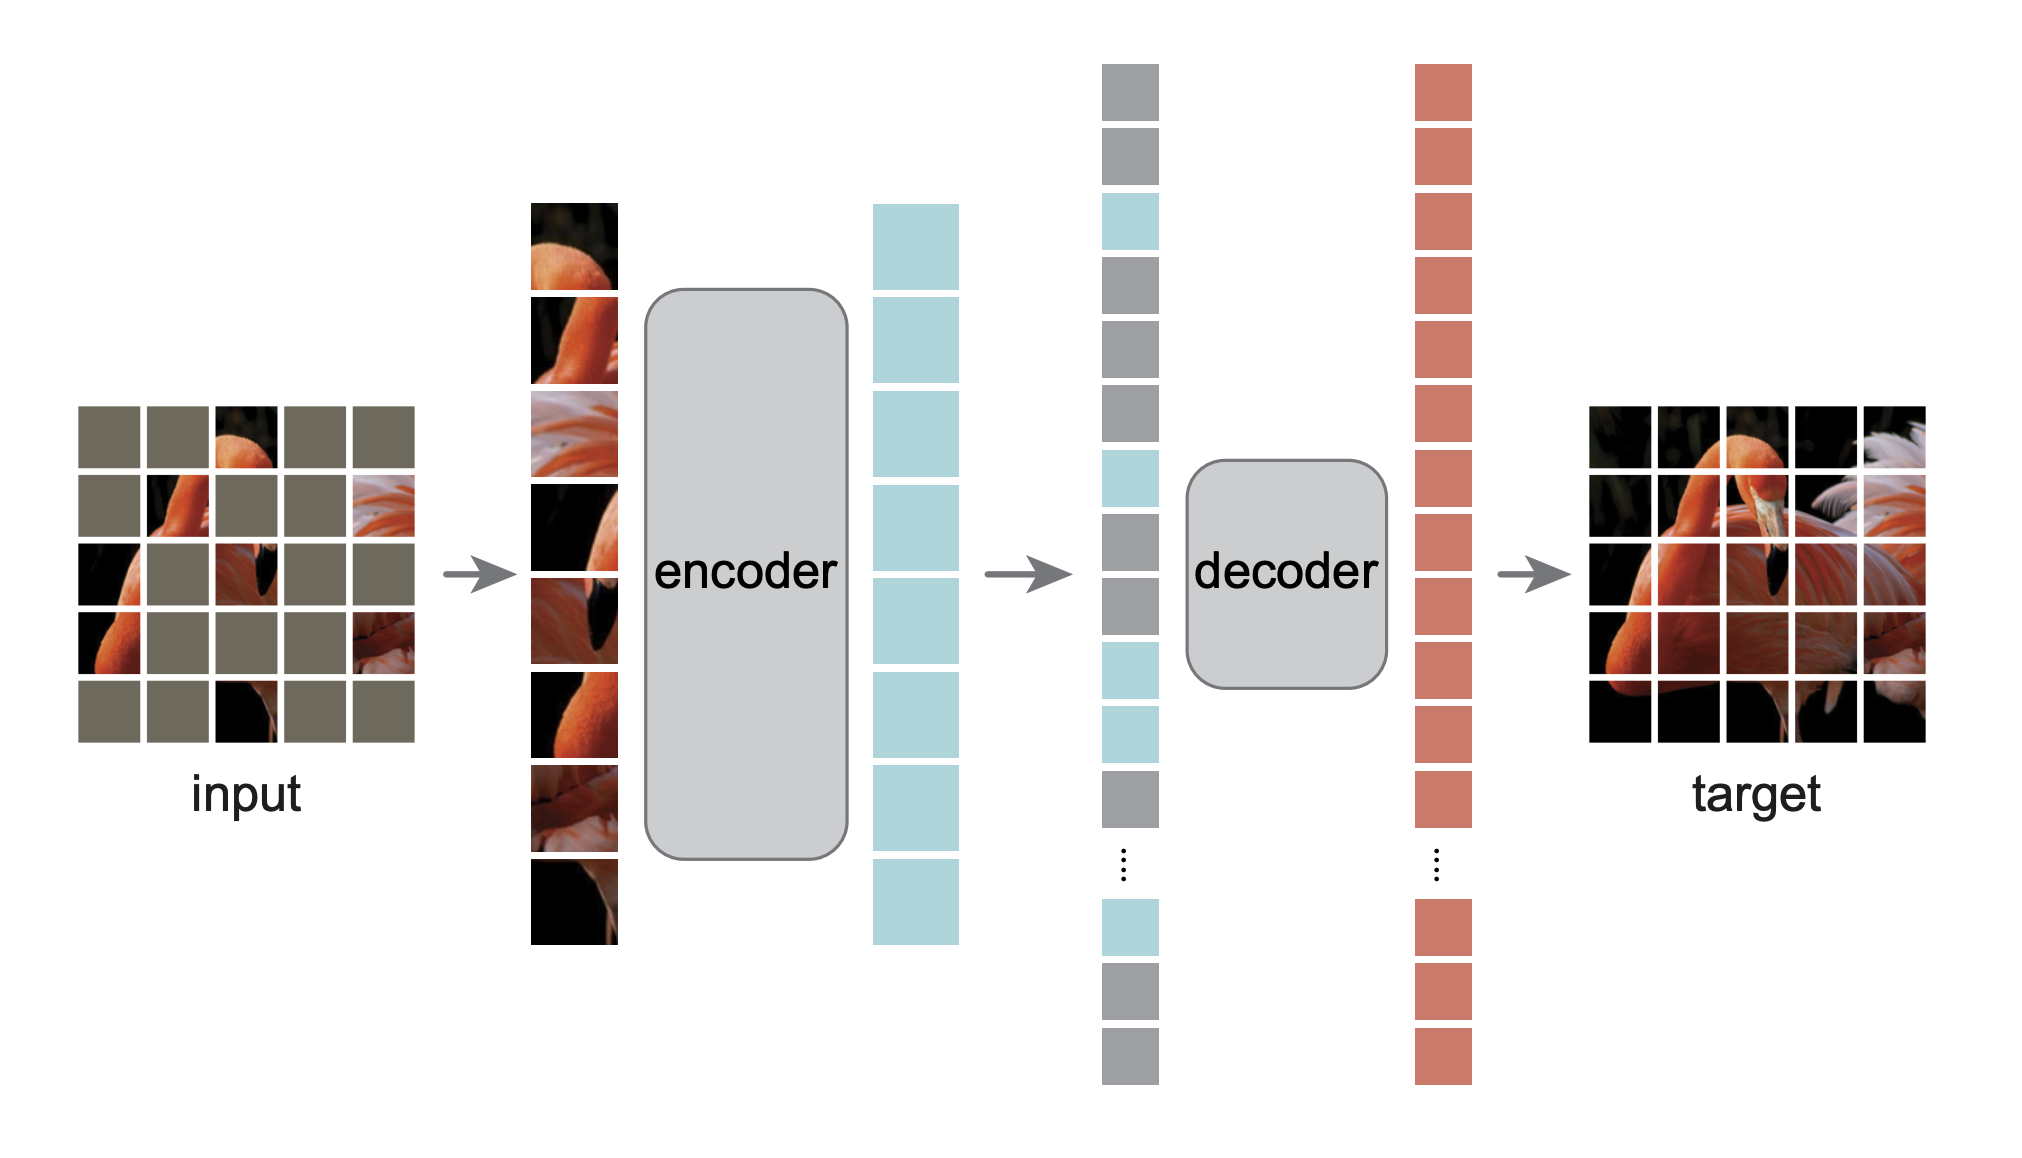 Все исходные контрольные точки ViTMAE можно найти в организации [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Щёлкните по моделям ViTMAE в боковой панели справа, чтобы увидеть больше примеров применения ViTMAE к задачам компьютерного зрения.
Приведённый ниже пример демонстрирует, как восстановить отсутствующие пиксели с помощью класса [ViTMAEForPreTraining](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Примечания
- ViTMAE обычно используется в два этапа. Сначала выполняется самообучение с помощью [ViTMAEForPreTraining](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEForPreTraining), затем декодер отбрасывается, а энкодер дообучается. После дообучения веса можно подключить к модели, например [ViTForImageClassification](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTForImageClassification).
- Используйте [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для подготовки входных данных.
## Ресурсы
- См. этот [ноутбук](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb), чтобы узнать, как визуализировать восстановленные пиксели из [ViTMAEForPreTraining](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Вероятность dropout для всех полносвязных слоёв в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
qkv_bias (`bool`, *необязательный*, по умолчанию `True`) : Добавлять ли смещение (bias) к запросам, ключам и значениям.
decoder_num_attention_heads (`int`, *необязательный*, по умолчанию `16`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
decoder_hidden_size (`int`, *необязательный*, по умолчанию `512`) : Размерность скрытых представлений.
decoder_num_hidden_layers (`int`, *необязательный*, по умолчанию 8) : Количество скрытых слоев в декодере.
decoder_intermediate_size (`int`, *необязательный*, по умолчанию `2048`) : Размерность представлений MLP.
mask_ratio (`float`, *optional*, по умолчанию 0.75) : Доля числа замаскированных токенов во входной последовательности.
norm_pix_loss (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли нормализованные пиксели при обучении (см. таблицу 3 в статье). Использование нормализованных пикселей повышало качество представления в экспериментах авторов.
Это класс конфигурации для хранения настроек модели ViTMAEModel. Он используется для создания модели Vit Mae в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Параметры:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEConfig)) : Конфигурация модели.
Модель Vit Mae без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
noise (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Используется преимущественно для тестирования, чтобы контролировать случайность и обеспечивать воспроизводимость
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодировки. Используется в основном для применения модели к изображениям с более высоким разрешением.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** `ViTMAEModelOutput` или `tuple(torch.Tensor)`
Объект `ViTMAEModelOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ViTMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEConfig)) и входных данных.
Метод forward модели [ViTMAEModel](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **mask** (`torch.Tensor` формы `(batch_size, sequence_length)`) — Тензор, указывающий, какие патчи замаскированы (1), а какие нет (0).
- **ids_restore** (`torch.LongTensor` формы `(batch_size, sequence_length)`) -- Тензор, содержащий исходные индексы (перемешанных) замаскированных патчей.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Параметры:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель ViTMAE — трансформер с декодером сверху для предобучения в режиме самообучения.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor). Подробности см. в [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) для обработки изображений).
noise (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Используется преимущественно для тестирования, чтобы контролировать случайность и обеспечивать воспроизводимость
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодировки. Используется в основном для применения модели к изображениям с более высоким разрешением.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** `ViTMAEForPreTrainingOutput` или `tuple(torch.Tensor)`
Объект `ViTMAEForPreTrainingOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ViTMAEConfig](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEConfig)) и входных данных.
Метод forward класса [ViTMAEForPreTraining](/docs/transformers/v5.23.0/ru/model_doc/vit_mae#transformers.ViTMAEForPreTraining) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`) — Потеря пиксельной реконструкции.
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Логиты реконструкции пикселей.
- **mask** (`torch.Tensor` формы `(batch_size, sequence_length)`) — Тензор, указывающий, какие патчи замаскированы (1), а какие нет (0).
- **ids_restore** (`torch.LongTensor` формы `(batch_size, sequence_length)`) -- Тензор, содержащий исходные индексы (перемешанных) замаскированных патчей.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```